On-Premise vs. Cloud-LLM — wann lohnt welcher Setup?
Die ehrliche Kurzantwort
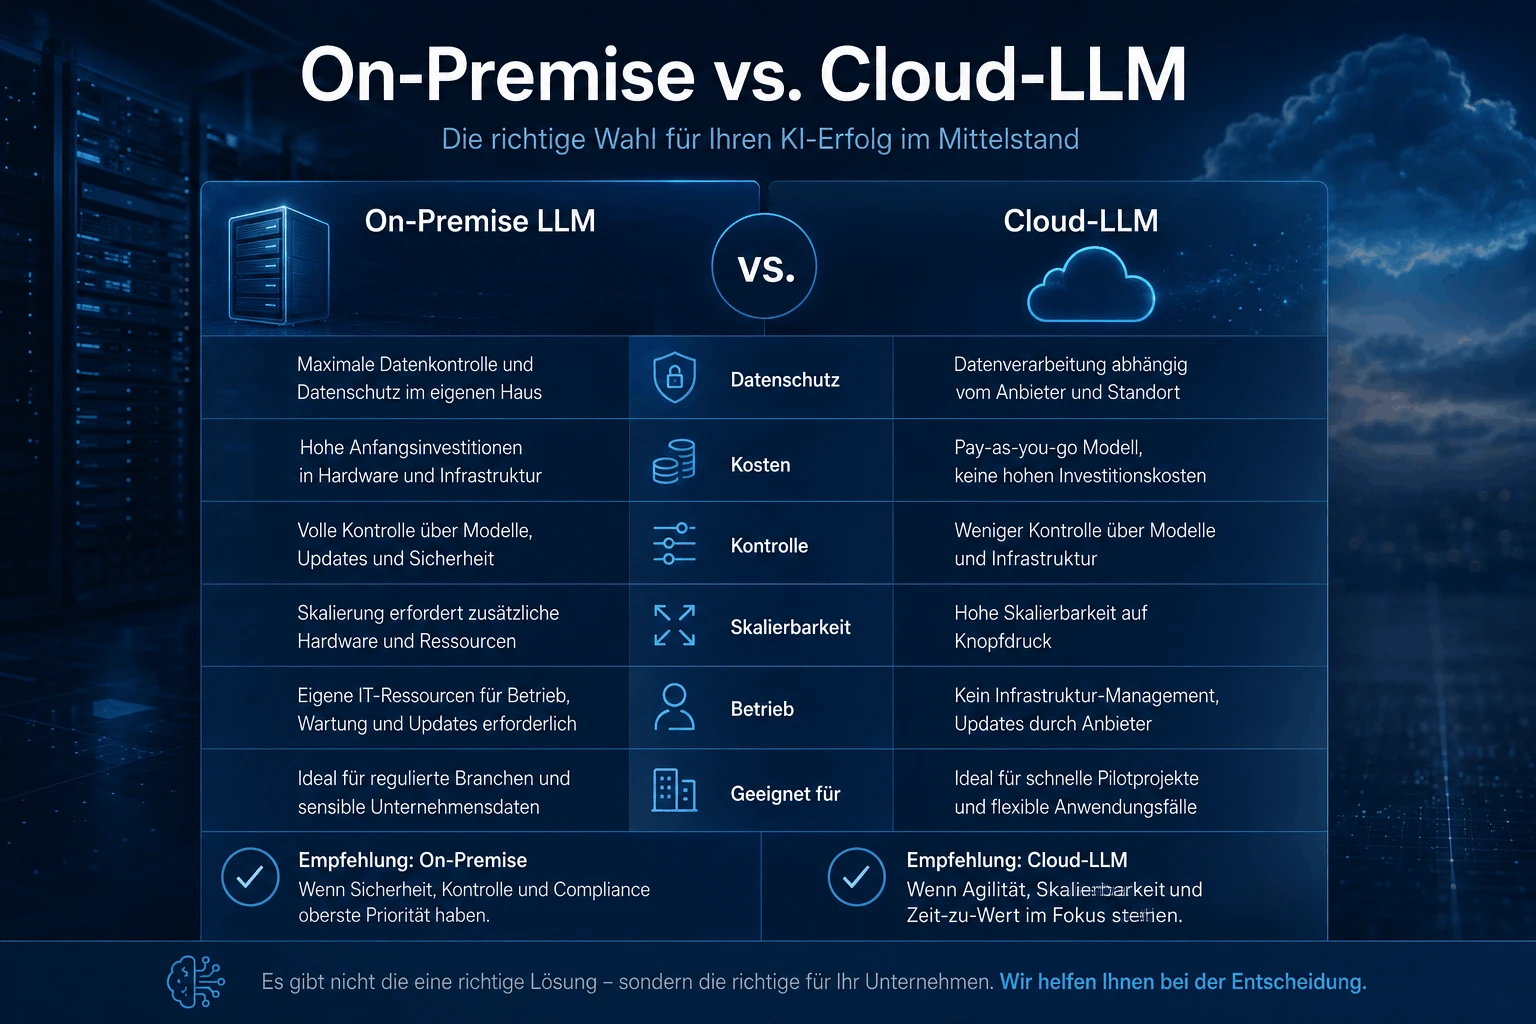
Es gibt vier klare Treiber für on-premise:
- Art.-9-DSGVO-Daten (Gesundheit, Religion, Gewerkschaft, ethnische Herkunft) — Cloud-LLMs sind hier auch mit AVV und EU-Region nur sehr eingeschränkt nutzbar
- Geschäftsgeheimnisse mit hoher Schadenshöhe — strategische Verträge, Vertriebsdaten, Patent-Skizzen, M&A-Material
- Latenz unter 50 ms p99 — Real-Time-Use-Cases (Trading-Signale, Robotik-Steuerung, Live-Voice-Agents)
- Cloud-Kosten stabil über ~2.500–4.000 €/Monat — ab dieser Schwelle wird die Eigeninvestition wirtschaftlich
- Auflagen verlangen den Betrieb im eigenen Haus — etwa weil die Risikobewertung eines Hochrisiko-Systems nach der KI-Verordnung dazu führt, weil Kunde, Versicherer oder KRITIS-Vorgaben es fordern oder weil Sie bei Berufsgeheimnissen (§ 203 StGB) keinen externen Dienstleister einbinden wollen. Die KI-Verordnung selbst schreibt keinen Ort vor. Wo eine Auflage es verlangt, entscheidet aber nicht der Preis.
Wenn keiner dieser fünf Punkte greift, ist Cloud schneller, billiger und sicherer — und das gilt für die meisten Mittelstandsfälle. Wer on-prem aus “Bauchgefühl Datenschutz” startet, baut typischerweise einen Hardware-Klotz, den niemand betreut.
Was Cloud-LLMs 2026 gut können
Azure OpenAI und Anthropic Claude sind 2026 die zwei realistischsten Cloud-Optionen für deutschen Mittelstand:
- Latenz: 200–800 ms für GPT-6 Sol oder Claude Sonnet 5.5 bei Standard-Kontext
- Skalierbarkeit: bis ~10 Anfragen/Sekunde ohne Sondervereinbarung
- Preis: laut Herstellern 2 USD je Million Input-Token und 10 USD je Million Output-Token für die Standardmodelle (GPT-6 Sol, Claude Sonnet 5.5), bis 10 und 50 USD für die Spitzenmodelle (Stand 29.09.2026)
- Verfügbarkeit: 99,9 % im SLA, in Praxis 99,95 %+
- Datenschutz: AVV + Trainings-Opt-Out + EU-Region (Sweden Central / Germany West Central für Azure; Claude in der EU über AWS Bedrock oder Google Cloud, die Claude-API direkt kennt nur „global“ und „us“)
- Modell-Updates: automatisch, ohne Eigenpflege
Für die meisten Workloads — Customer-Support-Chatbot, Mail-Klassifizierung, Dokumenten-Zusammenfassung, Code-Assistenz — ist das mehr als ausreichend.
Was on-prem 2026 kann
Die Modelle mit offenen Gewichten haben in den letzten 12 Monaten dramatisch aufgeschlossen — vor allem durch Mixture-of-Experts-Architekturen, die hohe Gesamtparameter bei kleinen “aktiven” Parametern je Token kombinieren. Stand 30.09.2026, alle Angaben laut Hersteller:
- Mistral Large 3 (Mistral, Dezember 2025): 41 B aktive / 675 B Gesamt-Parameter MoE, 256k Kontext, Apache 2.0. Nachfolger Mistral Large 4 ist seit 06.10.2026 als Vorschau per API verfügbar (1 Billion Parameter, 49 B aktiv); offene Gewichte laut Mistral Ende Oktober, Lizenz noch offen (Mistral, Ankündigung vom 06.10.2026); Selbstbetrieb siehe Mistral Large 4 im Unternehmen.
- Mistral Medium 3.5 (Frühjahr 2026): 128 B dense, 256k Kontext, offene Gewichte unter einer geänderten MIT-Lizenz. Achtung: Sie gilt nicht für Unternehmen, deren Konzern im Vormonat mehr als 20 Mio. USD Umsatz gemacht hat.
- Mistral Small 4 (März 2026): 119 B Gesamt / 6,5 B aktive Parameter, 256k Kontext, Apache 2.0. “Small” heißt hier nicht klein.
- Qwen3.8 (Alibaba, August 2026): Flaggschiff mit 2,4 T Gesamt / 95 B aktiven Parametern, dazu das dichte Qwen3.8-27B mit Bild- und Videoverständnis unter Apache 2.0. Anbieter China — on-prem-Betrieb ist die saubere Lösung.
- DeepSeek V4.1-Flash (DeepSeek, 10.09.2026): 552 B, 8–16 B aktiv, 1 Mio Kontext, Bild und Text, MIT-Lizenz.
- Muse Glimmer-30B (Meta, August 2026): rund 30 B dense, Text und Bild, Apache 2.0. Laut Meta in 4 Bit mit 24 bis 32 GB Grafikspeicher lauffähig, also auf einer guten Workstation.
Llama 4 ist für EU-Firmen raus. Scout und Maverick (Meta, April 2025) sind technisch weiter brauchbar, aber die Nutzungsrichtlinie von Llama 4 gewährt die Rechte an den multimodalen Llama-4-Modellen ausdrücklich nicht Unternehmen “with a principal place of business in the European Union”. Ein neueres Llama gibt es nicht, Meta veröffentlicht inzwischen unter dem Namen Muse.
Inferenz-Stack: vLLM (am performantesten, beste MoE-Unterstützung), SGLang (stark für strukturierte Outputs), Ollama (am einfachsten zu betreiben für Tier-1-Setups), llama.cpp (am vielseitigsten).
Hardware-Realität für Mittelstand:
MoE-Modelle brauchen viel Grafikspeicher für die Gewichte, obwohl nur ein Bruchteil davon je Token aktiv ist. Inferenz ist schneller als die Parameter-Zahl vermuten lässt, der Speicherbedarf aber hoch. Was die Hersteller selbst nennen:
- Muse Glimmer-30B: 24 GB (stark quantisiert), 32 GB (4 Bit), 64 GB (volle Genauigkeit).
- Mistral Small 4: Mindestausstattung laut Mistral 4× HGX H100, 2× HGX H200 oder 1× DGX B200.
- Mistral Medium 3.5: laut Mistral “as few as four GPUs”, ohne GPU-Typ.
- Mistral Large 3: kleinste genannte Ausstattung ein Knoten mit 8× H100 oder 8× A100 (NVFP4).
- DeepSeek V4-Flash: laut DeepSeek ein Knoten mit 4× GB300; für V4.1-Flash gibt es noch keine Angabe.
- Stromkosten realistisch 150–400 €/Monat plus Klima/Stellplatz
Die großen MoE-Modelle sind damit Rechenzentrumsklasse. Für eine einzelne Workstation kommen Modelle um 30 B Parameter in Frage.
Der TCO-Vergleich, der wirklich zählt
Cloud-Kosten für ein typisches Mittelstands-Setup (3 Use-Cases, ~5 Millionen Token Output pro Monat):
- OpenAI GPT-6 Sol (Azure oder direkt): ca. 50–150 €/Monat
- Anthropic Claude Sonnet 5.5: ca. 50–150 €/Monat
- Anbieter-Wartung: 0 €
- Total: 600–1.800 €/Jahr
On-prem-Kosten für vergleichbare Workload (1× H100 80 GB mit einem Modell der 30-B-Klasse wie Muse Glimmer-30B oder Qwen3.8-27B):
- Hardware-AfA über 3 Jahre: ca. 8.000–12.000 €/Jahr
- Strom + Klima: ca. 2.500 €/Jahr
- Engineering-Aufwand für Setup: 5–10 Tage initial, dann ~1 Tag/Monat
- Modell-Updates: ~2 Tage pro Update
- Total: 15.000–25.000 €/Jahr (ohne Initial-Setup-Aufwand)
Die Schwelle. On-prem rechnet sich erst, wenn:
- Cloud-Kosten über 2.500–4.000 €/Monat stabil liegen
- Oder ein zwingender Compliance-Grund vorliegt, der Cloud ausschließt
- Oder Real-Time-Latenz erfordert wird, die Cloud strukturell nicht liefern kann
Wenn on-prem die richtige Wahl ist
Wir bauen on-prem-Stacks für Mittelstandskunden in einem standardisierten Schema:
Hardware-Tier 1 (15.000–35.000 € einmalig):
- 1× Workstation mit 1× H100 80 GB oder 2× RTX 6000 Ada (48 GB)
- Reicht für Modelle um 30 B Parameter wie Muse Glimmer-30B oder Qwen3.8-27B
- Use-Cases: interne Recherche, Dokument-Analyse, Code-Assistenz für kleine Teams
Hardware-Tier 2 (sechsstellig):
- 1× Server mit 4 bis 8 GPUs der H100/H200-Klasse
- Reicht je nach Ausbau für Mistral Small 4, Mistral Medium 3.5 oder (mit 8 GPUs) Mistral Large 3
- Use-Cases: Customer-Support-Chatbot mit hohem Volumen, RAG-Pipeline mit Million-Dokument-Korpus, mehrere parallele Modelle
Software-Stack:
- vLLM oder TGI für Inferenz
- Qdrant oder Weaviate für Vector-Storage (auch on-prem)
- LiteLLM oder eigener Adapter für Provider-Abstraktion (zukunftssicher)
- Prometheus + Grafana für Monitoring
- Eigenes Audit-Logging mit Aufbewahrungsfristen
Betrieb:
- Hardware-Wartungsvertrag mit Hersteller
- Modell-Updates quartalsweise prüfen
- Re-Eval der Outputs gegen vorherige Version vor Rollout
Der hybride Mittelweg
Was wir bei Mittelstandskunden 2026 am häufigsten umsetzen: Hybrid-Architektur nach Daten-Klassifizierung.
- Grüne Daten (öffentlich, anonymisiert) → Cloud-LLM für Geschwindigkeit und Modellqualität
- Gelbe Daten (intern, ohne Personenbezug) → Cloud-LLM in EU-Region mit AVV
- Rote Daten (Art. 9, Geschäftsgeheimnisse) → on-prem-LLM auf eigener Hardware
Die Abstraktion läuft über einen Provider-Router (LiteLLM, LangChain LiteLLM, eigener Adapter), der pro Request anhand der Daten-Klassifizierung den passenden Backend wählt.
Was Sie heute nicht tun sollten
Keine GPUs kaufen “weil es trendy ist”. Keine Modell-Installation auf dem ESXi-Cluster ohne Eval-Setup (“läuft halt”). Keine “wir betreiben das selbst, ist sicherer” -Annahme ohne Risikoanalyse — eine schlecht betriebene on-prem-Installation mit fehlenden Patches ist unsicherer als gut konfiguriertes Azure OpenAI.
Pragmatischer Einstieg: 2–4 Wochen mit Cloud-LLM produktiv arbeiten, echte Volumen-Daten sammeln, dann basierend auf realem TCO entscheiden.
Dazu bei Krynex Labs
Passend dazu
Konkrete Frage zu eurem Setup?
Ein 30-Minuten-Erstgespräch klärt meistens schon, ob euer aktueller AI-Stack hält oder wo nachzuarbeiten ist. Kostenlos, ohne Verkaufsdruck.
Erstgespräch buchen