Wie schnell werden KI-Modelle besser? Die Zahlen von Januar bis September 2026
Beim Abspielen lädt YouTube (Google) das Video. Dabei werden Ihre IP-Adresse und Geräteinformationen an Google übertragen. Details ·
Transkript anzeigen
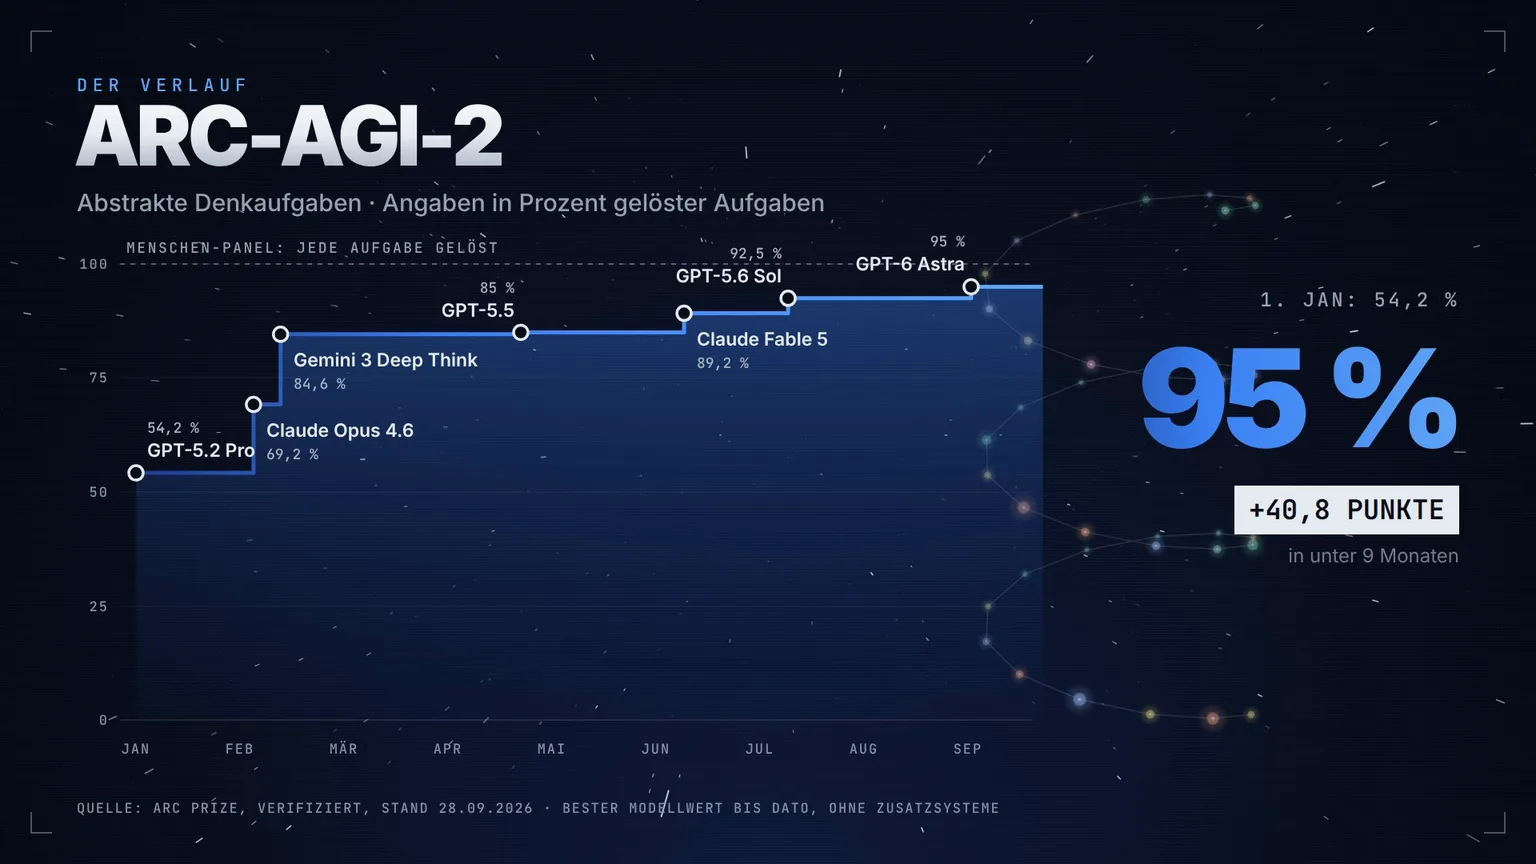
> 2026-01-01T00:00:00Z. > erfasse neue KI-Modelle …. > bereit. JAN → SEP 2026. NEUN MONATE. 38. MODELLE. EIN TEST. KI-MODELLE. 2026. DAS JAHR BIS JETZT. STAND: 29. SEPTEMBER 2026. ANTHROPIC · NOV 2025. Claude Opus 4.5. OPENAI · DEZ 2025. GPT-5.2. GOOGLE · NOV 2025. Gemini 3 Pro. 54 %. ARC-AGI-2. abstraktes Denken · GPT-5.2 Pro. 46 %. FRONTIERMATH TIER 4. Mathematik auf Forschungsniveau. ~6 STD. ZEITHORIZONT. METR, 50 % Erfolg · GPT-5.2. 01.01.2026 // 00:00 UTC. DIE STARTLINIE. So stand die Spitze an Neujahr. QUELLEN: ARC PRIZE · EPOCH AI (FRONTIERMATH TIER 4, V2) · METR. JANUAR 2026 · MOONSHOT AI · Kimi K2.5 · ARC-AGI-2: 11,8 %. FEBRUAR 2026 · ANTHROPIC · Claude Opus 4.6 · ARC-AGI-2: 69,2 % · NEUER BESTWERT. FEBRUAR 2026 · MINIMAX · MiniMax M2.5 · ARC-AGI-2: 4,9 %. FEBRUAR 2026 · GOOGLE · Gemini 3 Deep Think · ARC-AGI-2: 84,6 % · NEUER BESTWERT. FEBRUAR 2026 · ANTHROPIC · Claude Sonnet 4.6 · ARC-AGI-2: 60,4 %. FEBRUAR 2026 · GOOGLE · Gemini 3.1 Pro · ARC-AGI-2: 77,1 %. FEBRUAR 2026 · Z.AI · GLM-5 · ARC-AGI-2: 4,9 %. MÄRZ 2026 · OPENAI · GPT-5.4 · ARC-AGI-2: 74 %. MÄRZ 2026 · OPENAI · GPT-5.4 Pro · ARC-AGI-2: 83,3 %. MÄRZ 2026 · OPENAI · GPT-5.4 mini · ARC-AGI-2: 18,9 %. MÄRZ 2026 · OPENAI · GPT-5.4 nano · ARC-AGI-2: 5,7 %. 25.03.2026 · ARC PRIZE · ARC-AGI-3 startet · NEUER TEST · BESTE KI: 0,51 %. APRIL 2026 · ANTHROPIC · Claude Opus 4.7 · ARC-AGI-2: 75,8 %. APRIL 2026 · OPENAI · GPT-5.5 · ARC-AGI-2: 85 % · NEUER BESTWERT. APRIL 2026 · OPENAI · GPT-5.5 Pro · ARC-AGI-2: 84,6 %. MAI 2026 · GOOGLE · Gemini 3.5 Flash · ARC-AGI-2: 72,1 %. MAI 2026 · ANTHROPIC · Claude Opus 4.8 · ARC-AGI-2: 72,1 %. JUNI 2026 · ANTHROPIC · Claude Fable 5 · ARC-AGI-2: 89,2 % · NEUER BESTWERT. JUNI 2026 · Z.AI · GLM-5.2 · ARC-AGI-2: 22,8 %. JULI 2026 · OPENAI · GPT-5.6 Sol · ARC-AGI-2: 92,5 % · NEUER BESTWERT. JULI 2026 · OPENAI · GPT-5.6 Terra · ARC-AGI-2: 83,9 %. JULI 2026 · OPENAI · GPT-5.6 Luna · ARC-AGI-2: 59,5 %. JULI 2026 · THINKING MACHINES · Inkling · ARC-AGI-2: 36,5 %. JULI 2026 · XAI · Grok 4.5 · ARC-AGI-2: 52,6 %. JULI 2026 · MOONSHOT AI · Kimi K3 · ARC-AGI-2: 60,4 %. JULI 2026 · GOOGLE · Gemini 3.5 Flash-Lite · ARC-AGI-2: 10,3 %. JULI 2026 · GOOGLE · Gemini 3.6 Flash · ARC-AGI-2: 60,4 %. JULI 2026 · ANTHROPIC · Claude Opus 5 · ARC-AGI-2: 90,4 %. JULI 2026 · THINKING MACHINES · Inkling Small · ARC-AGI-2: 40,1 %. JULI 2026 · DEEPSEEK · DeepSeek V4 Flash 0731 · ARC-AGI-2: 61,4 %. AUGUST 2026 · XAI · Grok 4.6 · ARC-AGI-2: 67,1 %. AUGUST 2026 · DEEPSEEK · DeepSeek V4 Pro 0813 · ARC-AGI-2: 61,2 %. AUGUST 2026 · GOOGLE · Gemini 3.7 Flash · ARC-AGI-2: 84,6 %. SEPTEMBER 2026 · ANTHROPIC · Claude Fable 5.1 · ARC-AGI-2: 90 %. SEPTEMBER 2026 · OPENAI · GPT-6 Astra · ARC-AGI-2: 95 % · NEUER BESTWERT. SEPTEMBER 2026 · GOOGLE · Gemini 3.8 Flash · ARC-AGI-2: 89,2 %. SEPTEMBER 2026 · ANTHROPIC · Claude Opus 5.5 · ARC-AGI-2: 93,3 %. SEPTEMBER 2026 · OPENAI · GPT-6 Sol · ARC-AGI-2: 89,6 %. SEPTEMBER 2026 · OPENAI · GPT-6 Luna · ARC-AGI-2: 59,3 %. QUELLE: ARC PRIZE, VERIFIZIERTE BESTENLISTE ARC-AGI-2, STAND 28.09.2026 · MONAT LAUT ARC PRIZE UND EPOCH AI. KI-MODELLE // 2026. JAN. HIER GEZEIGT. x. MENSCHEN-PANEL: JEDE AUFGABE GELÖST. GPT-5.2 Pro 54,2 %. Claude Opus 4.6 69,2 %. Gemini 3 Deep Think 84,6 %. GPT-5.5 85 %. Claude Fable 5 89,2 %. GPT-5.6 Sol 92,5 %. GPT-6 Astra 95 %. DER VERLAUF. DER VERLAUF. ARC-AGI-2. Abstrakte Denkaufgaben · Angaben in Prozent gelöster Aufgaben. 1. JAN: 54,2 %. 54,2 %. +40,8 PUNKTE. in unter 9 Monaten. QUELLE: ARC PRIZE, VERIFIZIERT, STAND 28.09.2026 · BESTER MODELLWERT BIS DATO, OHNE ZUSATZSYSTEME. MENSCHEN-PANEL: JEDE AUFGABE GELÖST. START 25. MÄRZ →. Claude Opus 4.6 0,51 %. Claude Opus 4.8 1,52 %. GPT-5.6 Sol 7,78 %. Claude Opus 5 30,2 %. GPT-6 Astra 62,7 %. DER VERLAUF. ARC-AGI-3. Interaktive Denkspiele · gestartet am 25. März · in Prozent. AB 0,51 %. 0,51 %. ×123. in 23 Wochen. QUELLE: ARC PRIZE, STAND 28.09.2026 · STANDARD-HARNESS · MIT ANBIETER-ADAPTER: 99,95 % (GPT-6 ASTRA). MENSCHEN-PANEL: JEDE AUFGABE GELÖST. GPT-5.2 Pro 46 %. GPT-5.4 Pro 58,5 %. GPT-5.5 Pro 78 %. Claude Fable 5 90,2 %. GPT-6 Astra 97,6 %. DER VERLAUF. FRONTIERMATH TIER 4. Mathematik auf Forschungsniveau · in Prozent gelöster Aufgaben. 1. JAN: 46 %. 46 %. +51,6 PUNKTE. in unter 9 Monaten. QUELLE: EPOCH AI, FRONTIERMATH TIER 4 (VERSION 2), ABGERUFEN 29.09.2026 · BESTER WERT BIS DATO. AUTONOMIE. WIE LANGE ARBEITET KI ALLEIN? Länge von Software-Aufgaben in Menschenstunden, die das beste Modell zu 50 % schafft. VERLÄSSLICH BIS 16 H. MESSGRENZE ÜBERSCHRITTEN. 5,9 h · 1. JAN · GPT-5.2. 12 h · FEB · CLAUDE OPUS 4.6. 0,0 STD. Claude Mythos Preview (April): geschätzt 17,4 h, laut METR über 16 h nicht verlässlich. QUELLE: METR, TIME HORIZONS 1.1, STAND 08.05.2026. 16+ STD. KOSTEN. KLÜGER. JANUAR. 15,72 $. je ARC-AGI-2-Aufgabe · 54,2 %. GPT-5.2 Pro · Stand 1. Jan. SEPTEMBER. 0,41 $. je ARC-AGI-2-Aufgabe · 93,3 %. Claude Opus 5.5 · Sep. 38-MAL GÜNSTIGER. 39 PUNKTE MEHR. QUELLE: ARC PRIZE, KOSTEN JE AUFGABE IN US-DOLLAR, STAND 28.09.2026. KLÜGER UND GÜNSTIGER. 2024: +9,9 Punkte. 2025: +8,1 Punkte. 2026: +11,2 Punkte. WIRD ES LANGSAMER? WIRD ES LANGSAMER? NEIN. STÄRKER ALS 2024 UND 2025. EPOCH CAPABILITIES INDEX · ZUWACHS DES BESTEN MODELLS, 1. JAN → 25. SEP · ABGERUFEN 29.09.2026. UND ES IST ERST. SEPTEMBER. Q4 LÄDT …. STAND: 29. SEPTEMBER 2026. 2026 · 75 %. Jede Zahl mit Quelle. krynexlabs.de.
Die Startlinie am 1. Januar 2026
An Neujahr standen an der Spitze Claude Opus 4.5 (November 2025), GPT-5.2 (Dezember 2025) und Gemini 3 Pro (November 2025). Das beste Modell löste im Denktest ARC-AGI-2 54,2 Prozent der Aufgaben (GPT-5.2 Pro), in der Mathematik auf Forschungsniveau (FrontierMath Tier 4) 46 Prozent. Beim Zeithorizont, den METR misst, also der Länge von Software-Aufgaben in Menschenstunden, die das beste Modell zur Hälfte schafft, lag GPT-5.2 bei rund sechs Stunden.
Was sich bis September getan hat
| Messgröße | 1. Januar | September 2026 |
|---|---|---|
| ARC-AGI-2, bester Modellwert | 54,2 % | 95 % (GPT-6 Astra) |
| ARC-AGI-3, seit Start am 25. März | 0,51 % | 62,7 % (GPT-6 Astra) |
| FrontierMath Tier 4 | 46 % | 97,6 % (GPT-6 Astra) |
| Kosten je ARC-AGI-2-Aufgabe | 15,72 $ bei 54,2 % | 0,41 $ bei 93,3 % (Claude Opus 5.5) |
Beim Zeithorizont hat METR im April für eine frühe Vorschau von Claude Mythos geschätzt 17,4 Stunden gemessen. METR schreibt selbst, dass Werte über 16 Stunden mit der aktuellen Aufgabensammlung nicht verlässlich sind.
Der Film oben zeigt alle 38 Modelle mit einer 2026 erschienenen Version, die in der verifizierten ARC-AGI-2-Bestenliste von ARC Prize stehen, ohne Zusatzsysteme. Das ist keine Zählung aller 2026 veröffentlichten Modelle, sondern die Auswahl, die sich an einer Stelle einheitlich vergleichen lässt.
Wird es langsamer?
Nach den Daten nicht. Der Epoch Capabilities Index fasst viele Tests zu einer Zahl zusammen. Vom 1. Januar bis zum 25. September legte das jeweils beste Modell 2024 um 9,9 Punkte zu, 2025 um 8,1 und 2026 um 11,2. Für 2023 gibt es im Index kein vergleichbares Zeitfenster, die Daten beginnen im Februar 2023. Deshalb sagen wir nicht, es sei der größte Sprung überhaupt.
Was das für Unternehmen bedeutet
Benchmarks sind nicht Ihre Aufgabe. ARC-AGI misst abstraktes Denken, FrontierMath Mathematik auf Forschungsniveau. Ob ein Modell Ihre Eingangsrechnungen richtig liest oder Ihre Kundenmails im richtigen Ton beantwortet, sagt keiner dieser Tests. Dafür braucht es einen Vergleich mit 20 bis 50 echten Beispielen aus Ihrem Betrieb.
Eine Modellwahl hält nicht lange. Wer im Frühjahr ein Modell festgelegt hat, zahlt heute oft zu viel für dieselbe Qualität. Der Modellname gehört deshalb in die Konfiguration, nicht in den Code, damit ein Wechsel eine geänderte Zeile ist. Mehr dazu unter Vendor-Lock-in vermeiden.
Der Preis pro Token sagt wenig. Aussagekräftiger sind die Kosten je gelöster Aufgabe, und die sind in neun Monaten auf einen Bruchteil gefallen. Warum man nicht nur auf den Tokenpreis schauen sollte, steht unter LLM-Preise vergleichen. Die aktuellen Preise der großen Anbieter stehen in den Einträgen zu den Claude-Modellen und den OpenAI-Modellen.
Quellen
Alle Werte am 28. und 29. September 2026 abgerufen: ARC Prize (verifizierte Bestenlisten ARC-AGI-2 und ARC-AGI-3, Kosten je Aufgabe, bester Modellwert ohne Zusatzsysteme), Epoch AI (FrontierMath Tier 4 Version 2, Epoch Capabilities Index, Lizenz CC BY 4.0) und METR (Zeithorizonte).
Dazu bei Krynex Labs
Passend dazu
Konkrete Frage zu eurem Setup?
Ein 30-Minuten-Erstgespräch klärt meistens schon, ob euer aktueller AI-Stack hält oder wo nachzuarbeiten ist. Kostenlos, ohne Verkaufsdruck.
Erstgespräch buchen