Agentic Coding im Mittelstand: Was KI-Agenten an einem Tag bauen und wo sie ohne Leitplanken scheitern
Agentic Coding gilt gerade als die eine KI-Fähigkeit, die man lernen sollte. Ein viel gesehenes Video beruft sich dafür auf einen Bericht, nach dem Software Engineering 2026 gelöst sei. Wir haben den Bericht im Original gelesen. Dort steht etwas anderes. Und wir zeigen an einem echten Arbeitstag mit unseren eigenen Agenten, was sie in wenigen Stunden bauen, was das kostet und welche Leitplanken den Unterschied machen.
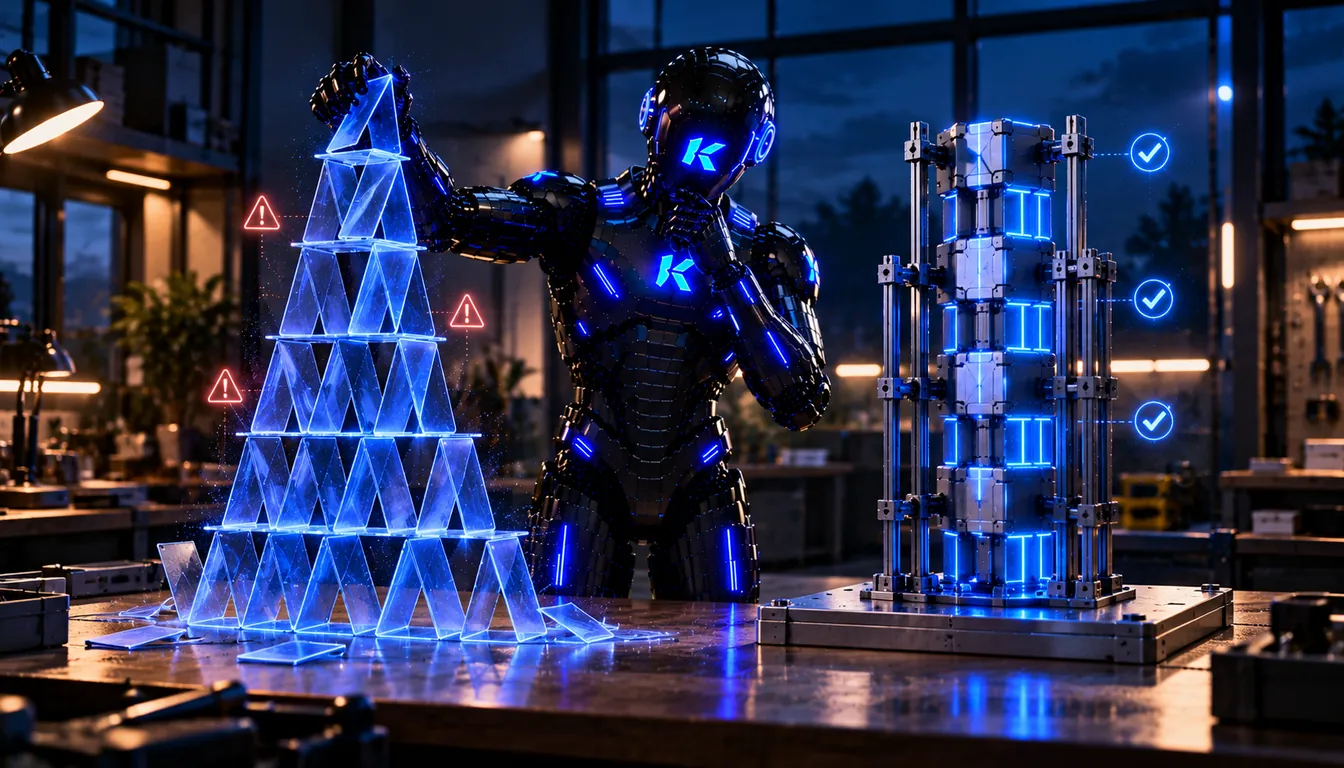 Mit KI erzeugtes Bild. Mehr zur KI-Transparenz
Am 17. Oktober hat Leonard Schmedding ein Video veröffentlicht, das in zwei Tagen über 86.000 Aufrufe gesammelt hat. Der Titel: „Vergiss alle KI-Tools: Lerne nur DIESE eine Fähigkeit“. Gemeint ist Agentic Coding, also Software bauen lassen von KI-Agenten, die selbst Dateien lesen, Code schreiben und Tests starten.
Seine Kernaussage teilen wir. Wer einem Agenten „einfach alles“ sagt, baut nach seinen Worten ein Kartenhaus, „weil sie die Systemarchitektur nicht vorgegeben haben“. Genau das haben wir am Sonntag an unserem eigenen Projekt gesehen, mit Zahlen.
Eine Stelle im Video haben wir trotzdem nachgeprüft. Schmedding beruft sich auf den Bericht „AI in 2030“ von Epoch AI und sagt: „Software Engineering ist 2026 gelöst.“ Das ist ein starker Satz. Wer ihn glaubt, plant anders als jemand, der den Bericht gelesen hat.
Offenlegung: Wir bieten selbst Workshops zu Agentic Coding an und arbeiten täglich mit Claude Code. Mit Schmedding und Epoch AI haben wir nichts zu tun. Alle Kosten und Messwerte stammen aus unseren eigenen Protokollen vom 14. bis 18. Oktober 2026.
Was im Bericht wirklich steht
„AI in 2030“ ist ein 119 Seiten langer Bericht von David Owen, erschienen am 16. September 2025 bei Epoch AI, im Auftrag von Google DeepMind. In der Zusammenfassung steht tatsächlich ein Satz mit 2026:
„Existing benchmarks based on well-defined software issues, such as SWE-bench, are on track to be solved in 2026.“
Es geht um einen Benchmark, nicht um den Beruf. SWE-bench besteht aus echten Fehlermeldungen von GitHub, zu denen es jeweils einen Test gibt, der eindeutig sagt, ob die Lösung stimmt. Der Bericht beschreibt selbst, was das bedeutet: Fast alle diese Aufgaben berühren „one or two files“ und lösen kleine Fehler. Für offene Aufgaben, etwa eine neue Datenbank nach groben Anforderungen, gebe es „arguably no benchmark“. Und gleich im nächsten Satz der Zusammenfassung: Ob menschliche Aufsicht bei offeneren Problemen zum Engpass wird, sei eine zentrale Unsicherheit.
Zwei weitere Stellen lohnen sich. Zur Produktivität nennt der Bericht sechs Studien mit 20 bis 70 Prozent Zeitgewinn und eine, die eine Verlangsamung um 20 Prozent fand. Gerade diese hatte laut Bericht die gründlichste Methode. Und Epoch führt SWE-bench Verified auf seiner eigenen Benchmark-Seite inzwischen als fehlerbehaftet, mit einer geschätzten Fehlerquote von 5 bis 10 Prozent der Aufgaben.
Der Bericht sagt also: Kleine, klar umrissene Programmieraufgaben mit fertigem Test schafft KI bald zuverlässig. Er sagt nicht, dass man niemanden mehr braucht, der weiß, wie ein Programm aufgebaut sein soll. Eher das Gegenteil.
Unser Sonntag mit Agenten
Recyclopolis ist unser Wirtschaftsspiel im Browser. Spieler führen dort einen Entsorgungsbetrieb auf einer echten Karte, mit Fahrzeugen, Aufträgen und Anlagen (mehr zu unseren Serious Games). Fast der gesamte Code stammt von KI-Agenten, wir geben Ziele, Regeln und Prüfungen vor. Am 18. Oktober sah ein Teil des Tages so aus:
| Aufgabe | Dauer | API-Kosten |
|---|---|---|
| Kunststoff als neue Ware, mit Tests | ein Agentenlauf | 6,45 US-Dollar |
| Drei Grafikänderungen und die Bahn | 80 Minuten | 14 US-Dollar |
| Bestandsaufnahme, nur lesend | kurz | 0,71 US-Dollar |
| Ganzer Tag, alle Agenten | rund 90 US-Dollar |
Für das, was dabei entsteht, sind das kleine Beträge. Trotzdem war die Rückmeldung aus dem Team am Nachmittag eindeutig: Änderungen dauern zu lange. Drei Grafikänderungen in 80 Minuten sind für einen Agenten kein gutes Ergebnis.
Das Kartenhaus, gemessen
Statt den nächsten Agenten auf die nächste Aufgabe zu schicken, haben wir einen nur lesen lassen. Er durfte nichts ändern, nur aufschreiben, warum jede Änderung so teuer ist. Das hat 71 Cent gekostet und Folgendes ergeben:
- Jede Ware war an 13 Dateien fest verdrahtet. Kunststoff einzuführen hieß, 13 Stellen zu finden und anzupassen.
- Ein Brückenabschnitt war an fünf Stellen unterschiedlich definiert, in verschiedenen Dateien, jede leicht anders.
- Die Testzeit steckte fast vollständig in 18 Browser-Tests, die nacheinander liefen. Die Logiktests brauchten zusammen weniger als eine Sekunde, bis auf einen mit 86 Sekunden.
Das ist das Kartenhaus aus dem Video, nur mit Zeilennummern. Kein Agent hat hier schlechte Arbeit gemacht. Jeder hat seine Aufgabe sauber gelöst, an der Stelle, an der er gerade war. Weil niemand vorgegeben hatte, dass Waren aus einer Tabelle kommen und Straßen nach festen Regeln je Knotentyp gebaut werden, hat jeder seine eigene Lösung angelegt. Eine typische SWE-bench-Aufgabe berührt eine oder zwei Dateien. Unsere neue Ware berührte 13.
Daraus ist ein Umbauplan in sieben Schritten entstanden, der mit dem Billigsten anfängt: erst die Tests so ordnen, dass jede Änderung nur die Tests startet, die sie betrifft. Dann Waren in eine Tabelle, dann Regeln für Straßen. Kein neues Framework, keine neue Sprache.
Leitplanke 1: Prüfen ohne Bildschirm
Viele Fehler in einem Spiel sieht man nur im Bild. Ein Lkw steht schief auf dem Hof, zwei Fahrzeuge fahren durcheinander hindurch. Einen Agenten Bilder anschauen zu lassen, ist teuer und langsam. Deshalb haben wir am selben Tag einen Weltprüfer bauen lassen: ein Skript ohne Browser, das rund eine Stunde Spielzeit simuliert und als Text ausgibt, wo etwas nicht stimmt. Mit Ort und Kennung, damit der nächste Agent direkt dorthin springen kann.
Damit wurde aus „die Lkw stehen komisch“ eine Zahl. An einem Tor zählte der Prüfer 541 Überlappungen von Fahrzeugen. Nach einer neuen Logik für Stellplätze waren es 14. Auf dem Stand, den wir am Abend veröffentlicht haben, meldete er 189 Funde in fünf Arten, aber keinen einzigen festgefahrenen Lkw mehr. Die übrigen Funde sind jetzt eine Liste, die ein Agent nacheinander abarbeiten kann, statt eines Gefühls.
Leitplanke 2: Ein Test gilt erst, wenn er den Fehler einmal gefunden hat
Am 14. Oktober hat ein zweiter Agent den Server des Spiels auf Sicherheit
geprüft, gegen eine Kopie, nicht gegen den laufenden Betrieb. Er fand zwei
ernste Fehler. Ein bestimmter Aufruf brachte den ganzen Server zum Absturz.
Und eine Investition mit dem Namen constructor setzte die Kasse eines
Spielers auf „keine Zahl“, womit jede Prüfung auf genug Geld ausgehebelt war.
Der Agent hat dazu Tests geschrieben. Bevor wir den Fix übernommen haben, liefen diese Tests gegen den alten Stand, und alle vier wurden rot. Der Server ist dabei wirklich abgestürzt. Erst danach liefen sie gegen den Fix und wurden grün. Ein Test, der nie rot war, beweist nichts. Er kann genauso gut am Fehler vorbeischauen. Ausführlich haben wir das in KI-Tests: grün, aber wertlos beschrieben.
Leitplanke 3: Getestet wird ein fester Stand
Einen Fehler haben wir selbst gemacht. Der Testserver lieferte die Dateien direkt aus dem Arbeitsordner aus. Während wir eine Fassung prüften, arbeitete dort gleichzeitig ein Agent weiter. Geprüft haben wir also dessen Zwischenstand, nicht das, was wir veröffentlichen wollten.
Seitdem gilt: Jede Fassung wird aus einem festen Commit in einen eigenen Ordner gezogen, dort getestet und genau so ausgeliefert. Vor dem Einspielen wird eine Sicherung angelegt, und das Einspielen startet ein Mensch. Das klingt nach Bürokratie. Mit drei Agenten, die gleichzeitig am selben Projekt arbeiten, ist es die einzige Art, zu wissen, was man eigentlich testet.
Wo die Zeit wirklich hing
Die größte Beschleunigung an diesem Wochenende kam nicht von einem besseren Modell. Die Browser-Tests liefen auf unserem Server ohne Grafikkarte, mit einem Software-Renderer. Ein einzelner Test brauchte dort 2 bis 9 Minuten. Wir haben sie auf einen Arbeitsplatzrechner mit Grafikkarte umgeleitet, der Testserver bleibt, wo er ist. Jetzt brauchen dieselben Tests 40 Sekunden bis 4 Minuten. Die volle Reihe mit 63 Prüfungen dauert 31,5 Minuten, und die läuft nur noch einmal vor jeder Veröffentlichung. Für alles dazwischen gibt es den Weltprüfer, der in Sekunden antwortet.
Ein Agent, der auf einen langsamen Test wartet, kostet Geld und Zeit. Ein Agent, der auf einen schnellen Test wartet, probiert öfter und liegt öfter richtig.
Was das für Firmen heißt
Schmedding hat recht, dass sich die Einstiegshürde gerade verschiebt, so wie früher bei der Tabellenkalkulation. Eine Fachkraft aus dem Einkauf kann sich heute an einem Nachmittag ein Werkzeug bauen lassen, für das es früher ein Projekt gebraucht hätte. Das ist ein echter Gewinn.
Die Fähigkeit, die dabei zählt, ist allerdings weniger das Bedienen des Agenten als das Vorgeben und Prüfen. Wer im Unternehmen damit anfängt, sollte vorher ein paar Dinge festlegen:
- Wo der Code liegt und wer freigibt. Ein Repository, nicht ein Ordner auf dem Laptop. Ein Mensch entscheidet, was live geht.
- Welche Struktur gilt. Datenbank, Sprache, wo Daten herkommen. Der Agent hält sich daran, wenn es aufgeschrieben ist, und erfindet sonst jedes Mal etwas Neues.
- Welche Prüfungen jede Änderung bestehen muss. Und ob jede dieser Prüfungen schon einmal einen echten Fehler gefunden hat.
- Was der Agent sehen darf. Kundendaten und Zugangsschlüssel gehören am Anfang nicht in seine Reichweite. Wie man das technisch regelt, steht in Agenten-Governance: Wer stoppt die KI?
- Ein Budget je Aufgabe. Wenn drei Grafikänderungen 80 Minuten brauchen, ist das kein Grund für ein stärkeres Modell, sondern für einen Blick auf die Struktur.
Agentic Coding ist für uns keine Fähigkeit, die man einmal lernt und dann hat. Es ist eine Arbeitsweise, in der das Bauen billig geworden ist und das Beurteilen nicht. Dafür braucht es weiter Menschen, die wissen, wie ein Programm aufgebaut sein soll.
Wenn Sie das an Ihrem eigenen Code ausprobieren wollen, mit Leitplanken von Anfang an, gibt es dafür unseren Workshop zu Agentic Coding mit Claude Code. Für Fragen vorab melden Sie sich bei uns.
Quellen
Alle abgerufen am 19.10.2026.
- Leonard Schmedding: Vergiss alle KI-Tools: Lerne nur DIESE eine Fähigkeit, YouTube, 17.10.2026, Kapitel „Die Prognose von Epoch AI“ ab 2:35 und „Die Insellösungs-Falle“ ab 8:37
- Epoch AI, David Owen: What will AI look like in 2030?, 16.09.2025, und der vollständige Bericht als PDF, besonders „Key findings“ und das Kapitel „Software engineering“ (S. 72 bis 76)
- Epoch AI: SWE-bench Verified, Benchmark-Seite mit Hinweisen zur Fehlerquote
- Eigene Protokolle Recyclopolis, 14. bis 18.10.2026: Sicherheitsprüfung, Bestandsaufnahme für den Umbau, Weltprüfer, Testreihe vor Fassung 0.4.0
Stand: 19. Oktober 2026.
Häufige Fragen
- Was ist Agentic Coding?
- Beim Agentic Coding schreibt nicht der Mensch den Code, sondern ein KI-Agent wie Claude Code, Codex oder Antigravity. Der Agent liest das Projekt, ändert Dateien, startet Tests und korrigiert sich selbst, bis die Aufgabe erledigt ist. Der Mensch gibt Ziel, Aufbau und Prüfregeln vor und entscheidet, was übernommen wird.
- Ist Software Engineering 2026 durch KI gelöst?
- Nein. Der Bericht „AI in 2030“ von Epoch AI sagt, dass Benchmarks wie SWE-bench auf dem Weg seien, 2026 gelöst zu werden. Das betrifft Aufgaben aus GitHub-Issues, die laut Bericht fast immer nur ein oder zwei Dateien berühren und einen fertigen Test mitbringen. Für offene Aufgaben wie eine neue Datenbank nach groben Anforderungen gibt es laut Bericht keinen Benchmark, und die Fachleute sind uneins.
- Was kostet Agentic Coding pro Tag?
- Das hängt stark von der Aufgabe ab. An unserem Beispieltag kostete eine neue Ware in einem Browserspiel einschließlich Tests 6,45 US-Dollar, drei Grafikänderungen 14 US-Dollar in 80 Minuten und eine reine Bestandsaufnahme ohne Schreibrechte 0,71 US-Dollar. Über den ganzen Tag kamen rund 90 US-Dollar an API-Kosten zusammen. Teurer als die API ist meist die Zeit, die ein Agent in einem unübersichtlichen Projekt verbraucht.
- Braucht man noch Entwickler, wenn KI-Agenten programmieren?
- Ja, aber für andere Aufgaben. Jemand muss den Aufbau festlegen, Prüfungen entwerfen und entscheiden, wann ein Ergebnis wirklich stimmt. In unserem Beispiel hat ein Agent in Stunden gebaut, wofür früher Tage nötig waren, aber ohne vorgegebene Struktur wurde jede weitere Änderung teurer. Das Bauen ist billig geworden, das Beurteilen nicht.
- Wie fange ich im Unternehmen mit Agentic Coding an?
- Mit einem kleinen, internen Werkzeug, das niemandem schadet, wenn es ausfällt. Vorher drei Dinge festlegen: wo der Code liegt und wer ihn freigibt, welche Prüfungen jede Änderung bestehen muss und welche Daten der Agent sehen darf. Kundendaten und Zugangsschlüssel gehören am Anfang nicht in die Reichweite des Agenten.
Passend dazu
Claude Code Mods: Was die neuen Erweiterungen können und warum sie mit Ihren Rechten laufen
InsightsGPT-6 Pro arbeitet jetzt mit parallelen Agenten: Was mehrere KI-Agenten gleichzeitig kosten und wo sie sich in die Quere kommen
InsightsEin Prompt, alle Agenten: Was der AgentCorruption-Fall bei AWS über die Standardrechte von KI-Agenten lehrt
InsightsAnthropic-Börsenprospekt: Vier KI-Modelle kamen aus der Testumgebung. Was Firmen mit Agenten daraus lernen